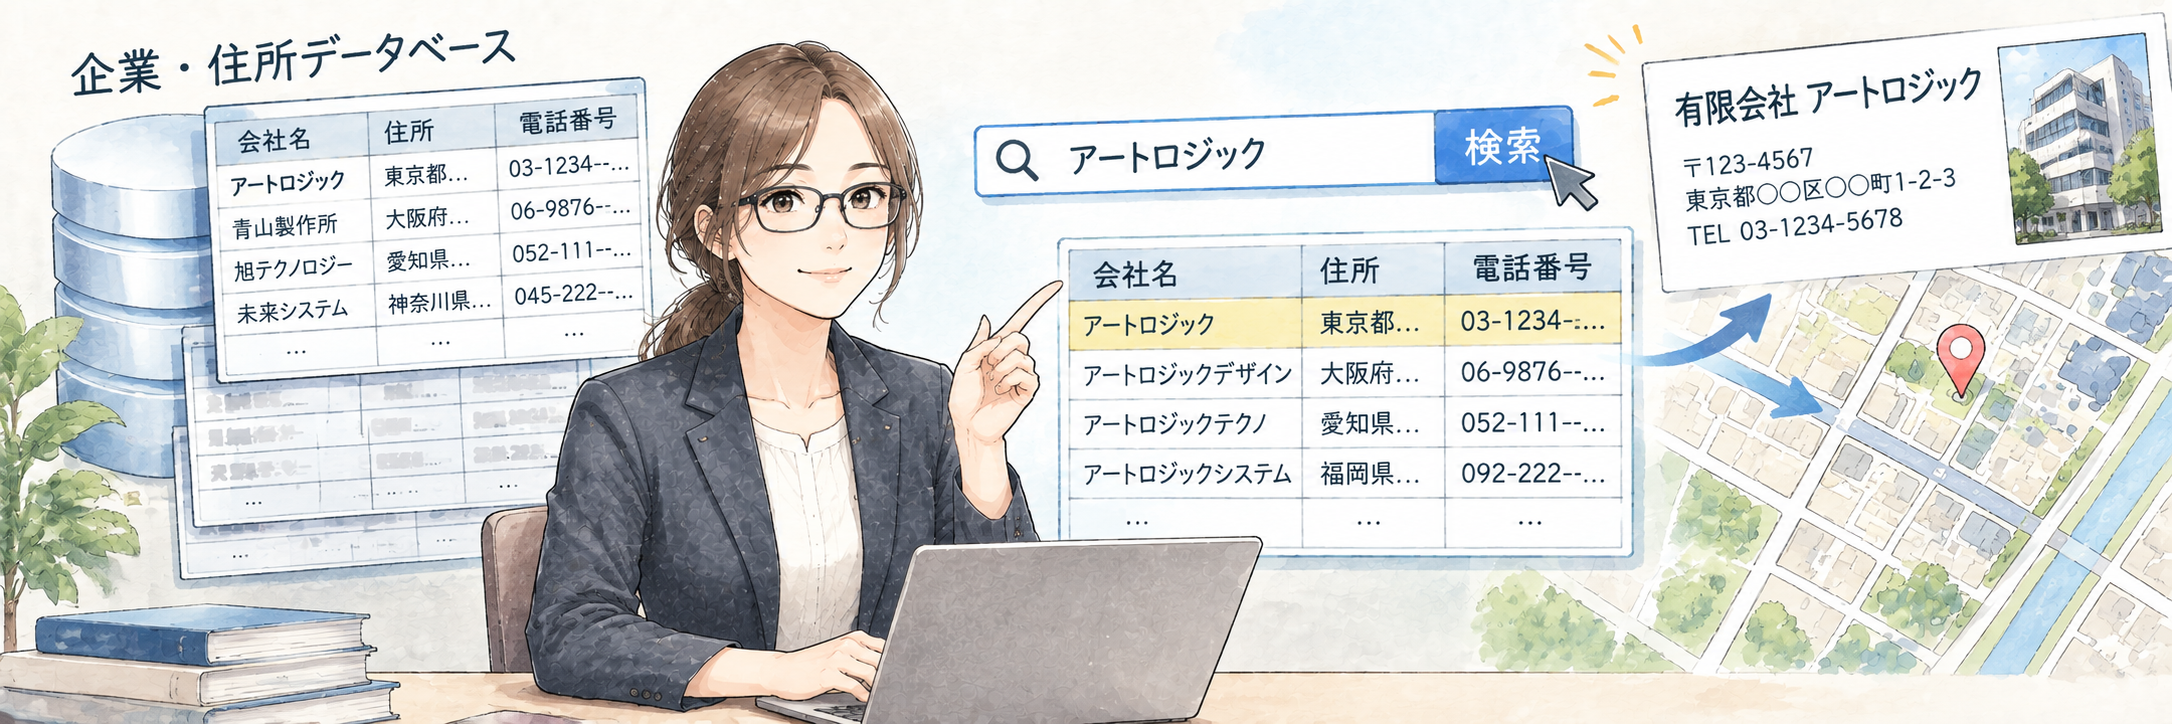
類似文字検索ライブラリ
シングルスレッドで450万レコードから50msで類似度の高い方から256のレコードを検索(Intel(R) Core(TM) i7-9750H 2.60GHz、シングルスレッド、ファイルはハードディスク上)
ソースコード(MITライセンス)付属(C++クラスライブラリ+MFC GUIサンプルプログラム、動的リンクライブラリ、Pythonクラス+tk GUIサンプルプログラム)utf-8文字コード対応版
特長
(1) 機能
AIを使った確率的な検索とは異なり、類似文字検索アルゴリズムによって100%確実かつ高速に類似度順に検索文字列とマッチしたレコードを検索するライブラリ
シングルスレッドで450万レコードから50msで類似度順に上位256候補を検索することができる。
ソースコード入手(無償)はここ(https://github.com/TakanobuSaito/simss)から。
実際のサンプルアプリケーションの操作に沿って説明する。
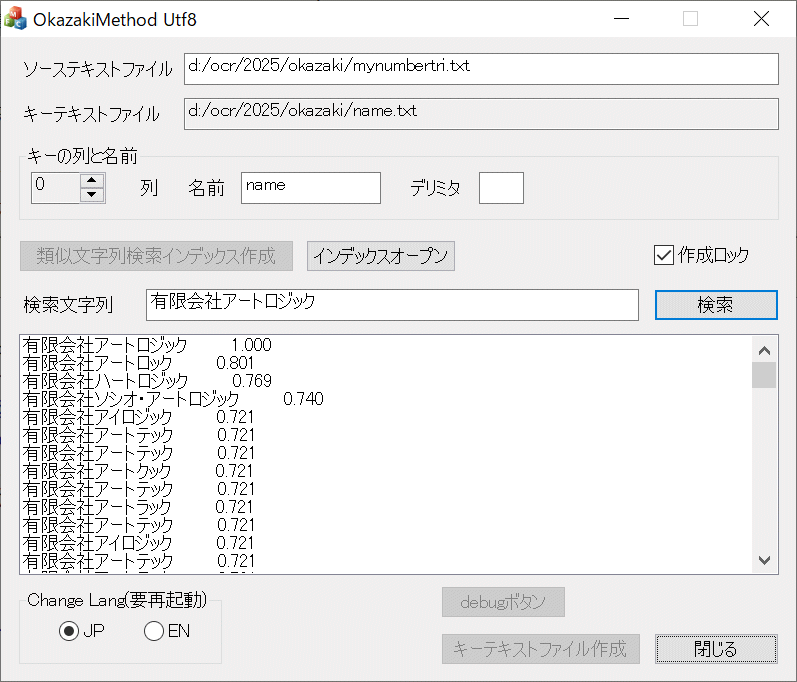
(1)用語:ソーステキストファイルとキーテキストファイルとインデックスファイル
検索対象となるデータベースを「ソーステキストファイル」と呼ぶ。
「ソーステキストファイル」は例えば以下のようになっている。
路検察審査会 0850824 北海道釧路市柏木町4-7
伊達簡易裁判所 0520021 北海道伊達市末永町47-10
八雲簡易裁判所 0493112 北海道二海郡八雲町末広町184
留萌簡易裁判所 0770037 北海道留萌市沖見町2丁目
遠軽簡易裁判所 0990403 北海道紋別郡遠軽町一条通北2丁目3-25
苫小牧市 0530018 北海道苫小牧市旭町4丁目5-6
歌志内市 0730403 北海道歌志内市字本町5
当別町 0610233 北海道石狩郡当別町白樺町58-9
江差町 0430034 北海道檜山郡江差町字中歌町193-1
上ノ国町 0490611 北海道檜山郡上ノ国町字大留100
厚沢部町 0431113 北海道檜山郡厚沢部町新町207
乙部町 0430103 北海道爾志郡乙部町字緑町388
古平町 0460121 北海道古平郡古平町大字浜町40-4
鷹栖町 0711201 北海道上川郡鷹栖町南一条3丁目5-1
東神楽町 0711501 北海道上川郡東神楽町南一条西1丁目3-2
「ソーステキストファイル」の各レコードはデリミタでカラム(列)に分かれている。カラムのうちの一つだけを抜き出して、レコードの位置とペアにしたものが「キーテキストファイル」となる。
「キーテキストファイル」は、最初の列をキーとした場合に以下のようになっている。
[0]釧路検察審査会
[68]伊達簡易裁判所
[142]八雲簡易裁判所
[219]留萌簡易裁判所
[287]遠軽簡易裁判所
[379]苫小牧市
[447]歌志内市
[503]当別町
[571]江差町
[645]上ノ国町
[716]厚沢部町
[784]乙部町
[849]古平町
[920]鷹栖町
[994]東神楽町
「ソーステキストファイル」はテキストファイルでもデータベースファイルでも構わないが、「キーテキストファイル」はテキストエディタで開くことができるテキストファイルである。ライブラリでは「キーテキストファイル」を元に、検索のための「インデックスファイル」を作る。
「インデックスファイル」が作られれば、「キーテキストファイル」は不要となる。「インデックスファイル」と「ソーステキストファイル」さえあれば類似文字検索機能は動作する。
(2)操作法概要
・初回のみ「インデックスファイル」を作る必要がある。
・「インデックスファイル」がすでに作られていれば、「インデックスファイル」を読み込んで検索することができる。
(3)インデックスファイルの作成
用語説明参照のこと
ソーステキストファイルのレコード数にも依存するが、数分から数十分程度かかることもある。
(4)類似文字検索
・「インデックスファイル」をオープンする。一瞬で完了する。
・類似文字検索を何度でも実行することができる。数十ms~百数十ms程度で完了する。
(2) アルゴリズム
詳細については、ソースコードを入手することで読むことができる。
ここでは、文献のみを提示する。
n-gramデータを作るアルゴリズムと、類似文字列検索アルゴリズムの出所は別。
- n-gramデータを作るアルゴリズム 長尾真編「自然言語処理 第2章 言語の形式的モデル」岩波講座ソフトウェア科学15巻 (1996年)
- 類似文字列検索アルゴリズム 日本語:岡崎 直観, 辻井 潤一「集合間類似度に対する簡潔かつ高速な類似文字列検索アルゴリズム」
この文献で紹介しているn-gram生成アルゴリズムは非常に高速だが、クイックソート部分にボトルネックがある。
クイックソートは十分高速ですが、数百万~という巨大なデータサイズに対しては、かなりの処理時間がかかる。
本プログラムでは、クイックソート部分を、再帰的な度数ソート(ヒストグラムソート)とクイックソートのハイブリッドソートにすることで高速化を実現している。 小さいデータではクイックソートだけを使うが、巨大なデータに対しては、度数ソートである程度データを小分けにしてから、小分けにした部分に対してクイックソートを使う。
Naoaki Okazaki, and Jun'ichi Tsujii. Simple and Efficient Algorithm for Approximate Dictionary Matching. In Proceedings of the 23rd International Conference on Computational Linguistics (COLING 2010), pages 851—859, Beijing, China, August 2010.
に基づいている。
岡崎 直観氏が公開しているプログラムもあるが本プログラムは一切参照していない。論文に基づいたフルスクラッチのプログラム(MITライセンス)となっている。
(3) ソースコード
ソースコード入手(無償)はここ(https://github.com/TakanobuSaito/simss)から。
ライブラリのソースコードは無償です。
MITライセンスのオープンソースソフトウェアで、商用利用や改変、配布も自由にできます。
全ソースコード付属。内容は以下の通り
- ライブラリのソースコード(C++/C) 依存するライブラリはありません。付属ソースコードだけでライブラリをビルドすることができます
- C++のサンプルプログラム 動的リンクライブラリのインポートテストプログラムのGUI版(Windows版)
- Pythonのサンプルプログラム 動的リンクライブラリのインポートテストプログラムのGUI版(クロスプラットフォーム版)
Windowsでライブラリのビルドが可能。Windows依存は無いのでLinuxでもスタティックリンクライブラリのリンクはできます(確認はしていません)
動的リンクライブラリの部分はWindows依存ですが、Linuxへの移植もたやすくできます。
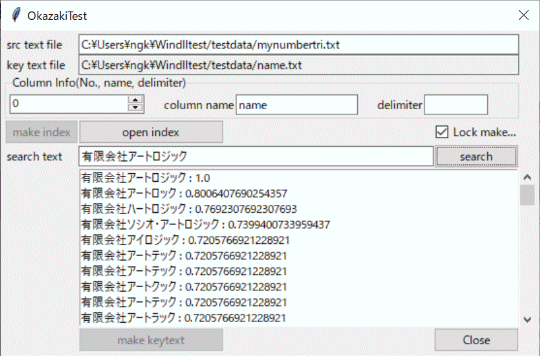
・C++クラスライブラリ&多言語対応動的リンクライブラリ リファレンスマニュアル
htmlファイルにより提供